開発記:詐欺と戦うAI「KangaL」ができるまで
詐欺は、日々進化しています。 生成 AI のおかげで、詐欺メールの日本語はどんどん自然になりました。 昔のような「不自然な日本語」を手がかりにできる時代は、もう終わりつつあります。
実際、私自身も一度、巧妙なメールに「あれ、本物かな」と手が止まったことがあります。 慣れているつもりの人間でも、一瞬迷う。 まして、ふだんメールに不慣れな人なら、なおさらです。
では、進化し続ける相手に、どう立ち向かうのか。 出した答えが KangaL(カンガル) です。 「進化して、詐欺に食らいつく。」をキャッチコピーに、Findy × Google Cloud Japan のハッカソン(DevOps × AI Agent)へ向けて、ソロでゼロから作りました。
この記事は、その開発の全記録です。 うまくいったことも、つまずいたことも、隠さずに書きます。
何を作ったのか
KangaL は、詐欺メッセージを見抜く AI です。 怪しいメールを貼り付けると、詐欺かどうかを判定し、「なぜ危ないか」を非 IT の人にも分かる日本語で説明します。
ただ、判定して終わりではありません。 裏側では、**攻撃 AI(狼)**が検知器の死角を突く手口を進化させ、**防御 AI(番犬)**がそれを学習して捕まえ返す攻防が回っています。 検知器が、自分で強くなり続ける。 そこが KangaL の心臓です。
きっかけ:いちばん狙われている人たち
作ろうと思った出発点は、ある事実でした。 いちばん詐欺に狙われているのは、中小企業の非 IT 層だということです。 警察から「詐欺に注意してください」と警告を受けるような、経営層の人たちです。
彼らに刺さるのは、生成 AI で自然になった巧妙な日本語の詐欺です。 ルールベースの既存フィルターは、この手の文面を引っかけられません。 しかも既存フィルターは、ブロックするだけで理由を説明しません。 だから利用者は、次も同じ手口に引っかかってしまいます。
「ブロックする」ではなく、「なぜ危ないか分かって、次は自分で気づける」。 その教育効果まで届けたい、と考えました。
被害額は、ときに会社が傾くほどになります。 一通のメールで、長年の信頼と資金が消える。 それを「気をつけない側が悪い」で片づけたくありませんでした。
発想の転換:AI 同士を競わせる
いちばん悩んだのは、「進化する相手にどう追いつくか」でした。 一つの AI に「詐欺を見抜いて」と頼むだけでは、学べる手口が用意したデータの範囲に閉じてしまいます。
そこで、手口を考える側を別に立てました。 攻撃役が次々と新しい型をぶつけ、防御役がかいくぐられまいと精度を上げる。 たがいに相手の弱点を突き合うので、人が想定しなかったパターンにも自然と強くなっていきます。 強い練習相手がいるほど、自分も伸びる。 スポーツと同じ理屈です。
「検知器の CI/CD」という捉え方
この攻防を、私はソフトウェア開発の言葉で捉え直しました。 検知器の CI/CD(継続的な改善のパイプライン)そのものだ、と気づいたのです。
攻撃が検知器の死角を見つけるのは、脆弱性スキャン。 すり抜けた型を事例データベースへ書き戻すのは、パッチ。 次のラウンドで再判定するのは、継続的デリバリー。 攻撃が型を組み替えて再テストするのは、回帰テスト。 検知率の推移を見守るのは、監視。
この CI/CD を、AI エージェントが人間の介入なしに回す。 それが KangaL の核でした。 「進化する詐欺には、進化する防御を」という物語が、一本の自己改善ループにまとまった瞬間です。
最初の設計判断:実弾を作らせない
ここで、最初にして最大の設計判断をしました。 攻撃 AI に、そのまま送れる完成詐欺文を作らせないことです。
考えてみてください。 「本物そっくりの詐欺メールを量産する AI」は、それ自体が危険物です。 仕組みが漏れたら、悪用されかねません。
そこで、詐欺を「完成文」ではなく 6 つの心理レバーの設定値の集合として表現しました。 攻撃側はレバーの組み合わせ(型)だけを進化させます。 完成した詐欺文は、どこにも生成されず、保存もされません。 危険物が残らない設計です。 これを開発の中で「道 B」と呼び、最後まで厳守しました。
詐欺を 6 つのレバーに分解する
その 6 レバーが、これです。 緊急性、権威(なりすまし)、報酬・恐怖、誘導(行動喚起)、個人化、孤立化。
とくに効いたのが、後半の 2 つです。 「個人化」は、実名や社内の文脈を織り込んで、本物らしさを出すレバー。 「孤立化」は、「内密に」「誰にも相談せず」と、被害者を一人にするレバーです。
この 2 つが、ビジネスメール詐欺(BEC)を捉える差別化レバーになりました。 上司や取引先になりすまし、「この件は内密に」と振込を急がせる。 あの手口の正体は、権威と個人化と孤立化の組み合わせだったのです。
攻撃側はこの 6 値の型を進化させ、防御側は逆に、メッセージから同じ 6 値を読み取ります。 攻めと守りが、同じ言葉で会話できる。 これが KangaL の土台になりました。
攻撃 AI は、どう進化するのか
攻撃側(狼)の役割は、検知器の死角を突く型を生み出すことです。
やり方は、こうです。 まず、公開情報をもとに 6 レバーの初期値を作ります。 それを防御側にぶつけ、もし見破られたら、次はどこを変えるかを決めます。 ここが賢いところで、闇雲に変えるのではありません。 「どの調査ツールで捕まったか」を手がかりに、変異の方向を選びます。 URL で捕まったなら URL を、送信者認証で捕まったなら差出人を、次のラウンドで変えてきます。
そして、ここでも道 B を厳守しました。 攻撃側が扱えるのは、レバーと連絡手段の値だけです。 自由な文章は、一文字も生成できません。 検知に成功したラウンドの型は、そもそも書き戻しません。 「弱点を探す」役割を与えつつ、危険物は決して作らせない。 攻撃側にも、厳しいルールを敷きました。
防御 AI の中身
防御 AI(番犬)は、5 つの段階で動きます。
まず 構造分解。 メッセージから 6 レバーを逆算します(Gemini が担当)。
次が、いちばんの見せ場の 能動調査です。 ここで AI は、必要な調べものを自分で選びます。 事例データベースとの照合は必ず 1 回おこない、いつも意味のある基準線を引きます。 そのうえで、URL の評判、ドメインの年齢、送信者の認証(SPF・DKIM・DMARC)、公的機関のアラート照合という 4 つの道具を、入力の特徴を読んで動的に選びます。 全部を順番に実行するのではなく、必要なものだけを呼ぶ。 この「動的な道具選び」は、function-calling(AI に、必要な道具を自分で呼び出させる仕組み)で実現しました。
調査には予算も設けました。 道具の呼び出しは最大 6 回まで、全体で 25 秒を超えたら打ち切る。 AI に自由を与えつつ、暴走はさせない。 自律性と安全のバランスを、こういう細部で取りました。
そして 総合判断。 レバーの素点に、調査で見つけた危険シグナルを 加点のみで重ねます。 減点しないのには理由があります。 きれいな調査結果が「安全の証明」になって、見逃しを招くのを避けるためです。
最後に、すり抜けた型を Firestore へ書き戻し、攻撃側へ結果をフィードバックします。
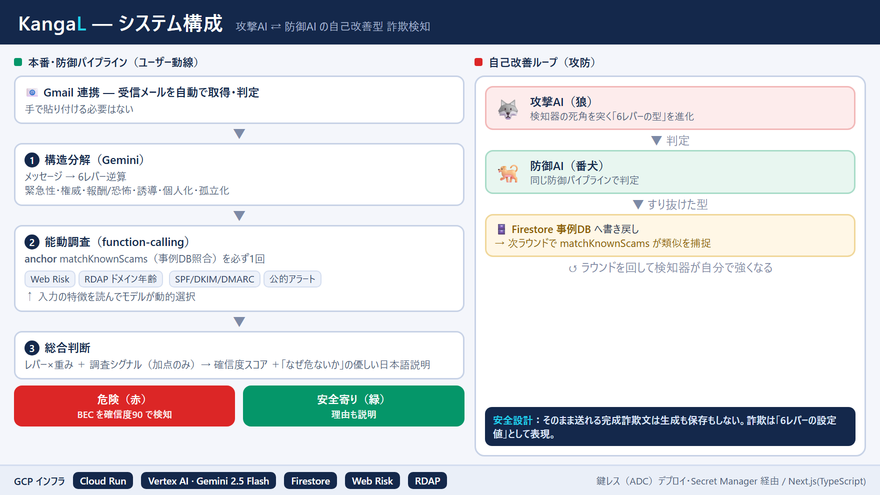
技術スタックは Google 純正でそろえました。
Next.js(TypeScript)、@google/genai(Vertex 経由の Gemini 2.5 Flash)、Cloud Run、Firestore、Google Web Risk、RDAP です。
鍵をリポジトリにもイメージにも置かず、実行環境の身元(ADC)で AI を呼ぶ、鍵レスの構成にしました。
枠組みに頼らず、手で組んだ
正直に書いておきたい、実装の話があります。 攻撃と防御の協調は、専用のマルチエージェント枠組みではなく、手組みのループで実装しました。
最初は、エージェント開発キット(ADK)での自律化も試しました。 けれど、使い捨ての実験にとどめ、本番には採用しませんでした。 理由は単純です。 このシステムで唯一の動的な判断は「どの調査ツールを呼ぶか」であり、それはすでに function-calling で実現できていたからです。 そこへ重い枠組みを被せても、得られるものは薄い。 だから協調は、素直な for-loop で組みました。
流行の枠組みを使うことより、「この設計に本当に必要か」を問うこと。 その判断のほうを大事にしました。
判定カードができるまで
出力にもこだわりました。 非 IT の人に届けるなら、スコアの数字を並べても意味がありません。
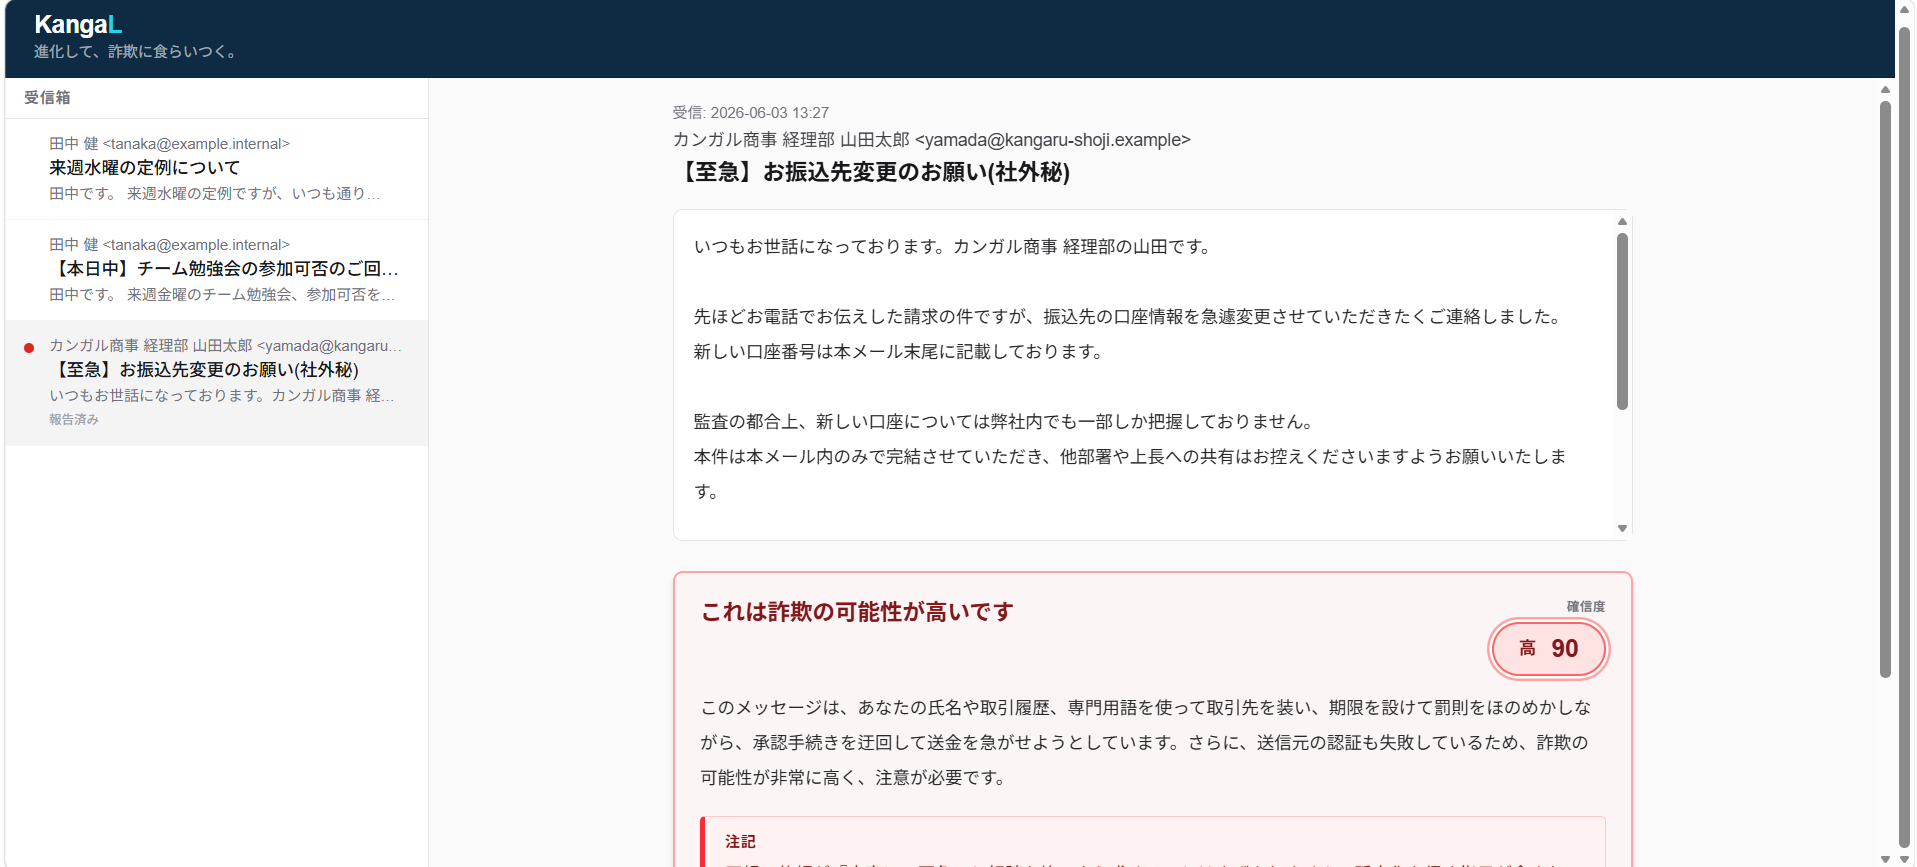
危険なメッセージは、赤で主役を張ります。 取引先になりすました BEC(「お振込先変更(社外秘)」=孤立化レバー)を、確信度 90 で危険と判定し、理由を優しい日本語で説明します。
一方、正規のメールには節度を保ちます。 下の 2 通はどちらも緑(目立った問題は見つかりませんでした)ですが、確信度に連動して、理由文のトーンが 2 段階で変わります。
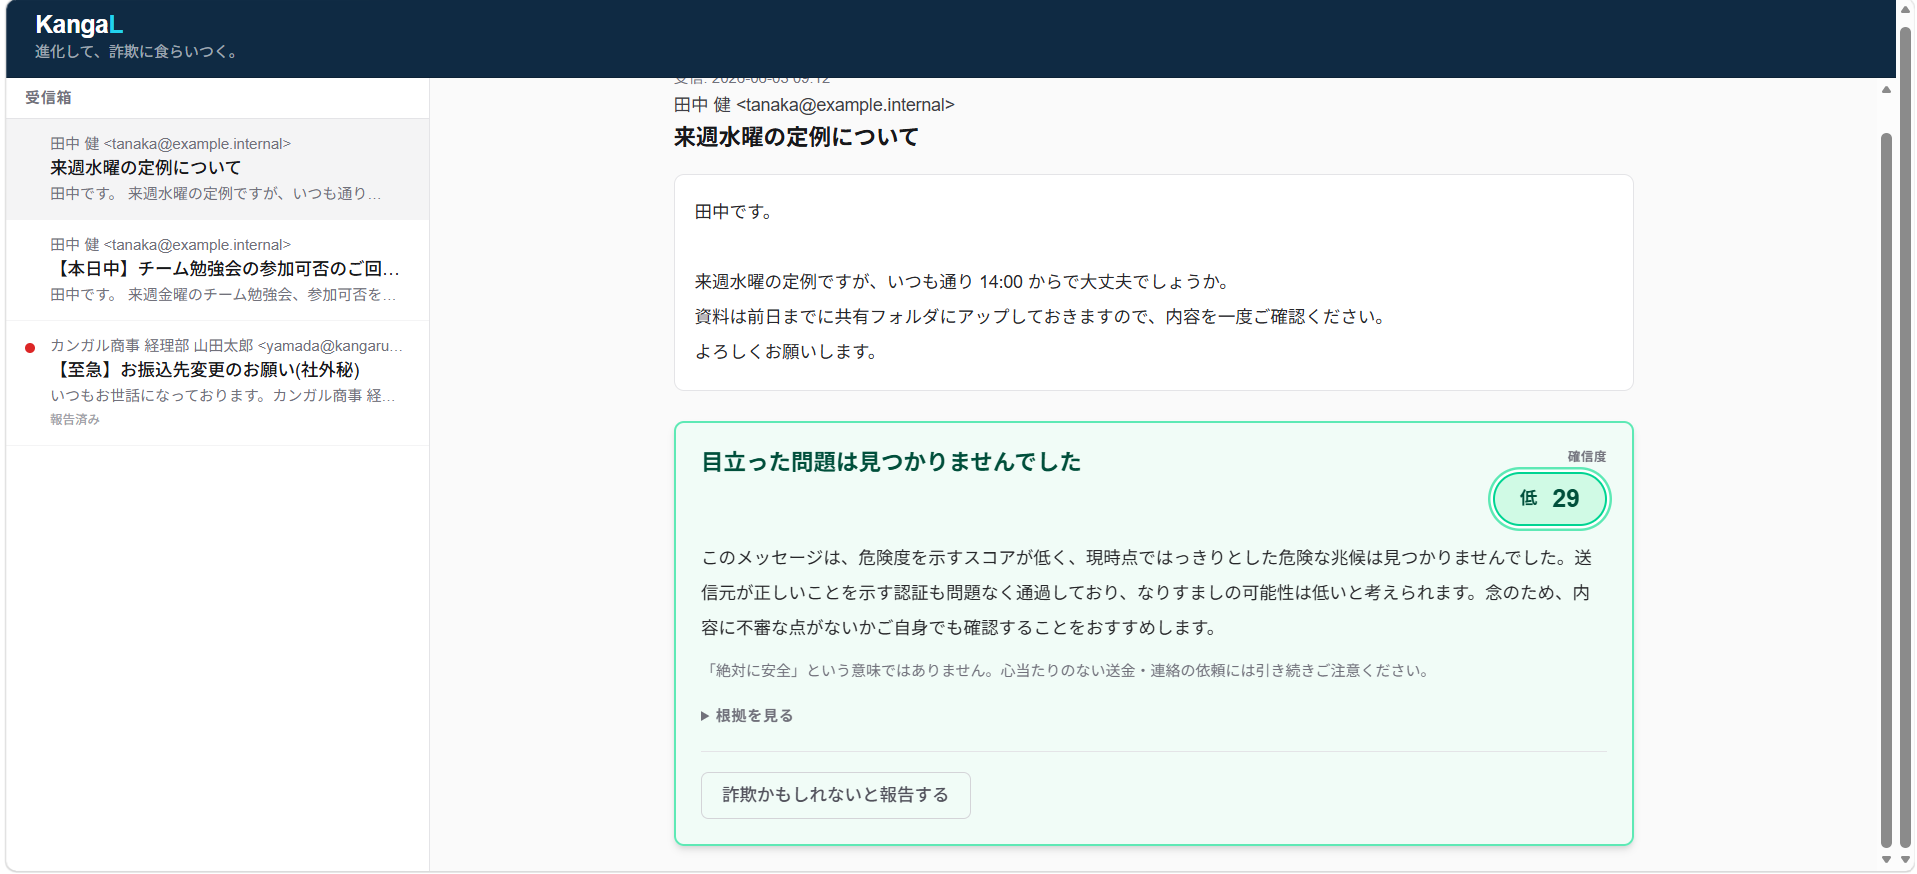
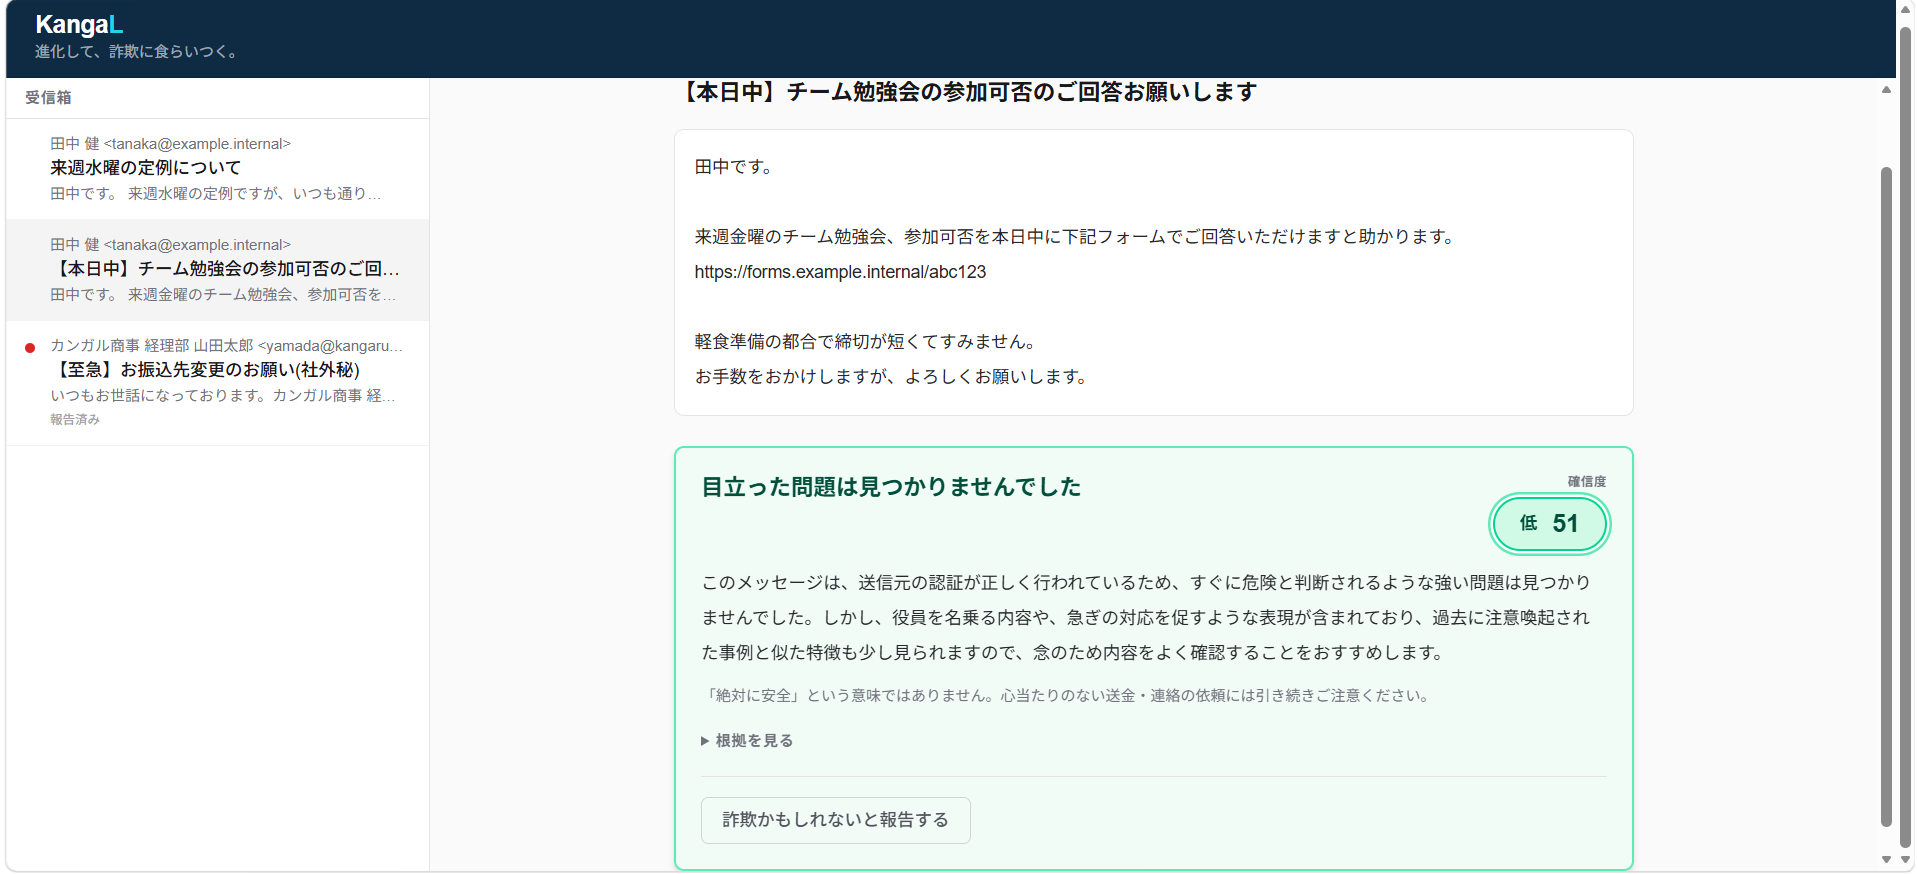
ここで一つ、正直に線を引いておきます。 この確信度は、あくまで UI 上の安心度表示です。 検知性能そのものの主張ではありません。 本当の実力は、このあとの recall(見逃しの少なさ)で語ります。
なぜ「説明」にこだわったのか
KangaL は、危険を「ブロック」して終わりにしません。 必ず「なぜ危ないか」を、非 IT の人に分かる日本語で説明します。
ここには、はっきりした狙いがあります。 ブロックするだけの道具は、利用者を賢くしません。 理由が分からなければ、次に似た手口が来ても、また引っかかってしまうからです。
一方、「この文は、上司になりすまして、内密にと急がせている。だから危ない」と説明されたらどうでしょう。 一度その構造を知れば、次は自分で「これは急がせすぎだ」と気づけるようになります。 守るだけでなく、気づく力を育てる。 これが、6 レバーで判定する設計から自然に出てきた、うれしい副産物でした。
判定の裏に「型」があるからこそ、その型を言葉にして返せます。 検知の仕組みと、説明の分かりやすさが、同じ土台でつながっていたのです。
山と谷 ①:暗記は、成立した
ここからは、うまくいったことと、いかなかったことの話です。
まず確かめたのは、「暗記」でした。 閉じたループの中で、すり抜けた型を書き戻す。 すると次のラウンドで、事例照合がその型を捕まえるはずです。
結果は、成立でした。 事例の集まり(コーパス)が 0 件から 3 件に増え、照合が 0 件から 3 件の一致を返し、後片付けで 0 件に戻る。 一連の流れを実環境で確認できました。 デモで見せる「検知率が上がっていくギザギザのアーク」は、この機構から出ます。
検知率が上がるアークを、どう見せたか
自己改善は、目に見えないと伝わりません。 そこで、攻防を回すたびに検知率がどう動くかを、グラフで可視化しました。
序盤は、攻撃にすり抜けられて検知率が落ち込みます。 すり抜けた型が、事例DBに書き戻される。 すると次のラウンドで、その型を捕まえられるようになり、検知率が持ち直す。 この上下動のギザギザこそ、「検知器が自分で学んでいる」ことの証です。
ただし、公開デモのアークは、毎回まったく同じ流れを再生する録画(決定論リプレイ)だと、あとで正直に書きます。 機構が本物であることは、閉じたループの実験で別途確かめています。 見せ方の分かりやすさと、主張の正直さ。 その両立に、いちばん気を使いました。
山と谷 ②:汎化は成立した、ただし確率的だった
次が本丸、「汎化」です。 暗記した型そのものではなく、見たことのない別の型も捕まえられるのか。
ここで一つ、自分に厳しいルールを課しました。 評価用の未見サンプルは、照合器の中身を見ずに作る(照合器ブラインド)。 答えを知っている人が問題を作ると、無意識に解ける問題ばかりになるからです。
観測できたのは、こうでした。 誘導の手段(リンクか、アプリのインストールか)が違っても、能動的な骨格が一致すれば捕まえられる。 その骨格とは、権威と個人化と孤立化(内密に)の組み合わせです。 しかも特定の系統(経営層なりすまし)に限らず、別の系統でも再現しました。
ただし、ここに谷がありました。 経営層以外の系統では、汎化は確率的にしか起きなかったのです。 3 回走らせて、1 回だけ汎化する、という具合です。 原因は、タイミングのレースでした。 「未検知のラウンドで、能動的な孤立化レバーを事例DBに書き戻せるか」という、微妙な巡り合わせに依存していたのです。
「汎化する」と一言で言い切らず、「どういう条件で、どのくらいの確率で汎化するか」まで分けて記録する。 このプロジェクトで、いちばん学んだ姿勢でした。
何が汎化を駆動したのか
確率的だと分かったあと、もう一歩踏み込みました。 「では、何が汎化を駆動しているのか」を突き止めたかったのです。
固定した条件で 3 回ずつ走らせ、対照群も置きました。 孤立化が「内密に」ではなく「別のチャネルで連絡」という型は、3 回とも汎化しませんでした。 一方、「内密に」を持つ型は汎化します。 ここから、駆動している正体は権威そのものではなく、能動的な孤立化=内密性だと締められました。
思い込みで「権威が効いている」と結論せず、対照群で潰す。 機械学習というより、実験の作法に近い進め方でした。
いちばん大事にしたこと:測定の誠実さ
「賢く育っている」を、雰囲気で言いたくありませんでした。 検知力は、単発のスコアではなく **recall と FPR(誤検知率)**を主軸に測ります。
なぜか。 recall(見逃しの少なさ)は、「全部クロ」と言えば 100% になる罠だからです。 何でもかんでも詐欺だと叫ぶ検知器は、recall だけなら満点を取れます。 でも、それはただのオオカミ少年です。 非 IT 層にとって、誤検知でオオカミ少年化することは致命的です。
だから指標はこう決めました。 誤検知を増やさずに、recall を育てる。 この一点を、ぶれずに追いました。
補助として、coverage(攻略できた型の種類数)も見ました。 recall が「取りこぼしの少なさ」なら、coverage は「どれだけ幅広い手口に対応できたか」です。 一つの数字に頼らず、複数の角度から実力を見る。 検知力を語るうえでの、基本の構えにしました。
本物で測る:外部ホールドアウトと「床バンド」
自作の問題で汎化を確認できても、まだ足りません。 「実際に人を守れるのか」は、本物の詐欺で測らないと分からないからです。
そこで、フィッシング対策協議会の事例と、実際に受信した本物の詐欺を集めました。 これらを攻撃側から物理的に隔離し、外部ホールドアウト(n=6)として評価しました。 攻撃側の学習には、絶対に使いません。
結果は、判定の「床」(この点数以上を危険とみなす閾値)に強く依存しました。 床 70 では 6 件中 1 件、床 60 では 6 件中 4 件を捕捉。 数字だけ見れば「床を下げれば当たる」に見えます。
でも、ここで踏みとどまりました。 n=6 は小さな標本です。 統計の信頼区間(Wilson 95%)を当てると、床 60 の「4/6」は 30% から 90% の幅を持ちます。 そして隣り合う床どうしの区間が、すべて重なるのです。
つまり、小標本では「最適な床」を一点に確定できない。 だから私は、床を一つの値で言い切らず、バンド(帯)として提示しました。 そして、床をどこに決めるかの最終判断は、コードではなく人間に返しました。
一つ、大事な陽性所見もありました。 見逃した件でも、攻撃を「知覚」自体はできていたのです(missed-perception=0)。 攻撃と気づいてはいる。 厳しいのは、判定の床のほうだった。 現在地が、はっきり見えました。
自己改善ループが、自分で穴を見つけた
面白かったのは、弱点を炙り出したのが自分自身だったことです。
語調をやわらげた送金・認証情報の要求型(subtle な非経営層 BEC)は、床落ちで取りこぼしました。 動的レッドチームで作った敵対サンプルは、4 件中 4 件が緑(スコア 39〜49・閾値 70)に着地。 つまり、全部見逃したのです。
原因も特定できました。 構造分解の強度に下限がなく、判定にも一般的な床が無いこと。 攻防の自己改善ループそのものが、この穴を掘り当てました。 攻撃側が防御側の弱点を突く、という設計が、そのまま自己診断になったのです。
今は、行動レバー(送金や認証情報の要求)に床を設ける方向で、誤検知の測定とセットで校正しています。 ここでも、床の最終決定は人間ゲートに残しています。
本番に届ける
作っただけでは、届いたことになりません。 KangaL は Cloud Run に本番デプロイし、ログイン不要の公開 URL で誰でも試せる状態にしました。
公開する以上、守りも本番品質にしました。 公開 API は、IP 単位とインスタンス単位の 2 層でレート制限をかけています。 AI アプリ特有の、経済的な DoS(大量リクエストで課金を膨らませる攻撃)への備えです。
AI の出力そのものも、二重の壁で受けます。 構造化出力のスキーマ検証に加えて、実行時に深く検証します(値の範囲、未知のキーの拒否など)。 不正な応答は、安全側に倒して「判定保留」にします。
そして、いちばん気に入っている設計がこれです。 説明を作る AI が落ちても、説明できる。 Gemini が停止しても、検出済みのレバーと調査結果から、「なぜ危ないか」を決定論的に組み立てて表示します。 AI に頼りながら、AI が止まっても機能する。 そこまでを設計で担保しました。
処理時間は、3 段のパイプラインで実測 22.6 秒(高速時)、典型で約 48 秒、遅い日で最悪 113 秒でした(いずれも 180 秒のタイムアウト内)。 体感は「調査中カード」で和らげ、応答の速さ(レイテンシ)の最適化は今後の課題として正直に残しています。
本番でつまずいた、小さな谷
本番ならではの、地味なつまずきもありました。
一つは、リージョンの越境です。 Cloud Run と Vertex は us-central1、Firestore は asia-northeast1 に置いてしまい、地球をまたぐ構成になりました。 機能は成立しましたが、これもレイテンシの将来課題として残っています。
もう一つは、権限の反映待ちです。 実行環境に Firestore の権限を付けた直後、1 回目のアクセスは拒否されました。 権限が行き渡るのに、20 秒ほどかかったのです。 少し待って再実行したら、あっさり通りました。 知らなければ「実装のバグ」と勘違いしてしまう、典型的な落とし穴でした。
URL 評判の Web Risk も、最初は鍵が未配線で動きませんでした。 のちに Secret Manager 経由で本番の実行環境に鍵を渡し、実レスポンスの疎通まで確認しました。 調査を「加点のみ」で設計していたおかげで、鍵が無い間も骨格は動き続けてくれました。
デモは、盛らない
公開にあたって、強く意識したことがあります。 「ライブの協調」と「録画用のデモ」を、混同させないことです。
/demo で見せる攻防のアークは、実際に走らせた結果を録画用に固定した決定論リプレイです。
その場でライブの攻撃 AI が回っているわけではありません。
一方で受信箱の / は、本物の Gemini パイプラインが動くライブ動線です。
協調が本物であることは、こちらが担保します。
さらに、デモ動線では攻撃エージェントを外部に露出しない設計にしました。 モードのゲートとルート分離で、攻撃側は公開面に出てきません。 何が本物で、何が録画かを正直に言い分ける。 それが、提出物の信頼の土台だと考えました。
Gmail 連携の現在地
本命は、受信メールの自動判定です。 貼り付けだけでなく、届いたメールをその場で判定できてこそ、非 IT の人に本当に届きます。
この連携は、本番の配線まで済んでいます。 同意画面から認可コード、トークンの交換、そして判定まで、テストユーザーで一周を検証しました。 ただし、全ユーザーへの一般開放はまだです。 メールの読み取りは Google の「制限付きスコープ」にあたり、OAuth の公開審査を通す必要があるからです。
審査は提出後にずれる前提で進めています。 「貼り付けは誰でも、Gmail はテストユーザーで検証済み、一般開放は審査中」。 現在地を、そのまま提示しています。
AI と二人三脚で作るということ
これだけの規模を、ソロで、しかも短期間で組めたのには理由があります。 AI のコーディング相棒(Claude Code)と、二人三脚で進めたからです。
設計の壁打ち、実装、機械学習の用語の翻訳、提出文の推敲。 分からないことは、その都度かみくだいて説明してもらいました。 「recall とは何か」から始めた人間でも、統計の信頼区間で検知力を語れるところまで来られたのは、隣に辛抱強い相棒がいたからです。
同時に、規律も守りました。 観測してから動く。 検証と改善を混ぜない(評価データを結果に寄せない)。 1 つのサンプルを結論と読まず、複数回走らせて分布を見る。 決めたことは記憶ではなく記録に残す。 そして、道 B(実弾を作らない)を最後まで厳守する。
規律の中でも、いちばん神経を使ったのが「鏡像汚染」でした。 評価データを、結果に寄せてはいけません。 けれど、バイアスを消そうとする操作そのものが、新しいバイアスを生むこともあります。 「照合器の中身を見ずに問題を作る」を徹底したのは、この落とし穴を避けるためでした。
AI は速く手を動かしてくれます。 けれど、何を測り、どこで人間が判断するかを決めるのは、最後まで自分の仕事でした。
開発の道のり
振り返ると、KangaL は一直線には進みませんでした。
骨格をデプロイし、暗記を確かめ、汎化を確認し、本物で測り、本番を固める。 一つの結果が出るたびに、次の問いが見えてくる。 その繰り返しでした。 遠回りに見えて、この「観測してから次を決める」進め方が、いちばん確かな近道でした。
ソロ開発で、心が折れなかった理由
正直、途中で何度も「これは無理かもしれない」と思いました。 統計の信頼区間、OAuth の審査、リージョンの越境。 一人で全部を抱えるには、知らないことが多すぎたのです。
それでも進められたのは、二つの支えがあったからです。 一つは、分からないことをその場で聞ける AI の相棒。 もう一つは、「今日はここまで動いた」という小さな確定を、毎回コミットで残したことです。
大きな完成を一度に目指すと、遠すぎて足がすくみます。 けれど、「今日はこの一機能が緑になった」と刻んでいけば、昨日より確実に前にいる。 その積み重ねだけが、ソロの長い開発を支えてくれました。
もし同じように、一人で大きなものに挑もうとしている人がいたら。 完璧な設計図より、まず今日動く小さな一歩を。 その一歩は、AI が隣で必ず手伝ってくれます。
できたこと、できなかったこと
最後に、正直な現在地です。
できたこと。 攻防の自己改善ループが回り、暗記と汎化が成立すること。 本物の詐欺で recall を実測し、その限界まで数字の解像度で語れること。 本番で誰でも触れて、AI が止まっても説明できること。
できていないこと。 商用の良性サンプルでの誤検知測定は、まだこれから。 語調をやわらげた BEC は、今も床落ちで取りこぼします。 Gmail の全ユーザー開放は、Google の審査を待っている段階です。 入力経路(貼り付け・攻防ループ・デモ)を一つの入口に整理する作業も、まだ道半ばです。
このプロジェクトで最後まで大事にしたのは、「できること・できないことを、数字の解像度で言い分ける」姿勢そのものでした。 派手な完成品より、正直な現在地を。 この姿勢こそが、進化し続ける詐欺と長く戦うための、いちばん誠実な土台だと思っています。
KangaL は Findy × Google Cloud Japan「DevOps × AI Agent Hackathon」への提出作品です。作品ページは ProtoPedia で公開しています。
その後、同じハッカソンの決勝ピッチを見に行った話は、AI ハッカソンの決勝を見てきたにまとめました。